27. التجميع العنقودي وفق الفهارس
لا تستطيع قواعد البيانات استرجاع المعلومات إلا بالسرعة التي تقرؤها بها من القرص. تُحمَّل قواعد البيانات الصغيرة بالكامل في ذاكرة التخزين المؤقت RAM وتتخلص من قيود القرص الفعلي، أما في قواعد البيانات الكبيرة فسيكون الوصول إلى القرص الفعلي عاملًا مقيِّدًا لسرعة الوصول.
تُكتب البيانات على القرص بشكل انتهازي، لذا لا يوجد بالضرورة أي ارتباط بين ترتيب تخزين البيانات على القرص والطريقة التي ستصل بها التطبيقات إليها أو تنظّمها.
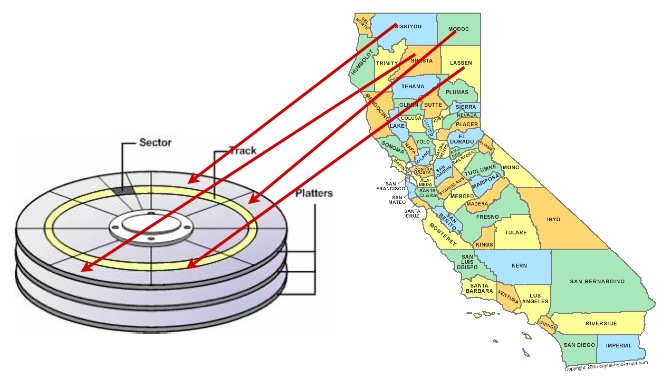
من طرق تسريع الوصول إلى البيانات ضمان أن تكون السجلات التي يُرجَّح استرجاعها معًا في مجموعة النتائج نفسها موجودة في مواقع فعلية متقاربة على أقراص القرص الصلب. ويُسمى هذا "التجميع العنقودي" (clustering).
قد يكون اختيار مخطط التجميع العنقودي المناسب أمرًا صعبًا، لكن هناك قاعدة عامة: تحدد الفهارس مخطط ترتيب طبيعيًا للبيانات يشبه نمط الوصول الذي سيُستخدم في استرجاعها.
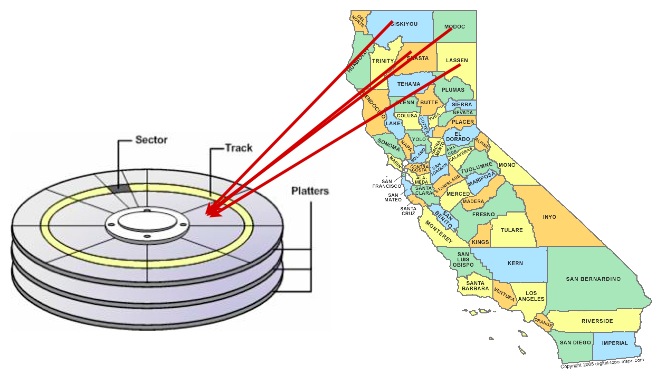
ولهذا فإن ترتيب البيانات على القرص بترتيب الفهرس نفسه قد يمنح ميزة في السرعة في بعض الحالات.
27.1. التجميع العنقودي وفق R-Tree
يُوصَل إلى البيانات المكانية عادةً عبر نوافذ مترابطة مكانيًا: فكّر في نافذة الخريطة في تطبيق ويب أو تطبيق سطح مكتب. جميع البيانات في النافذة لها قيم مواقع متقاربة (وإلا لما كانت في النافذة!)
لذا فإن التجميع العنقودي بناءً على فهرس مكاني منطقي للبيانات المكانية التي سيُوصَل إليها باستعلامات مكانية: فالأشياء المتشابهة تميل إلى أن تكون لها مواقع متقاربة.
لنُجرِ التجميع العنقودي للجدول nyc_census_blocks بناءً على فهرسه المكاني:
-- Cluster the blocks based on their spatial index
CLUSTER nyc_census_blocks USING nyc_census_blocks_geom_idx;
يعيد الأمر كتابة nyc_census_blocks بالترتيب الذي يحدده الفهرس المكاني nyc_census_blocks_geom_gist. هل تلاحظ فرقًا في السرعة؟ ربما لا، لأن البيانات الأصلية ربما كان لها مسبقًا ترتيب مكاني ما (وهذا ليس نادرًا في مجموعات بيانات نظم المعلومات الجغرافية).
27.2. القرص مقابل الذاكرة/SSD
تعمل معظم قواعد البيانات الحديثة على وحدات تخزين SSD، وهي أسرع بكثير في الوصول العشوائي من الوسائط المغناطيسية الدوّارة القديمة. كما تعمل معظم قواعد البيانات الحديثة على بيانات صغيرة بما يكفي لتتسع في ذاكرة RAM لخادم قاعدة البيانات، وينتهي بها المطاف هناك حين يخزّنها "نظام الملفات الافتراضي" لنظام التشغيل مؤقتًا.
هل لا يزال التجميع العنقودي ضروريًا؟
من المدهش أن الإجابة نعم. فإبقاء السجلات "المتقاربة" مكانيًا "متقاربة" في الذاكرة يزيد احتمال انتقال السجلات المترابطة معًا صعودًا في "تسلسل ذاكرة التخزين المؤقت الهرمي" للخادم، مما يجعل الوصول إلى الذاكرة أسرع.
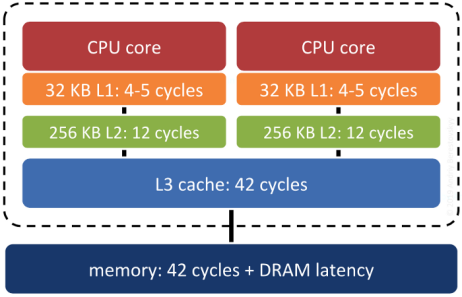
ليست ذاكرة RAM للنظام أسرع ذاكرة في الحاسوب الحديث. فهناك عدة مستويات من ذاكرة التخزين المؤقت بين ذاكرة RAM للنظام والمعالج الفعلي، ويحرّك نظام التشغيل والمعالج البيانات صعودًا وهبوطًا في هذا التسلسل الهرمي على شكل كتل. فإذا تصادف أن الكتلة المنقولة صعودًا تتضمن جزء البيانات الذي سيحتاجه النظام تاليًا... فهذا مكسب كبير. وربط بنية الذاكرة بالبنية المكانية طريقة لزيادة احتمال تحقق هذا المكسب.
27.3. هل تهم بنية الفهرس؟
نظريًا، نعم. عمليًا، ليس حقًا. فما دام الفهرس تقسيمًا مكانيًا "جيدًا إلى حد معقول" للبيانات، فإن المحدد الرئيسي للأداء سيكون ترتيب صفوف (tuples) الجدول الفعلية.
الفرق بين "عدم وجود فهرس" و"وجود فهرس" ضخم عمومًا وقابل للقياس بوضوح. أما الفرق بين "فهرس متوسط" و"فهرس ممتاز" فعادةً ما يتطلب قياسًا دقيقًا جدًا لتمييزه، وقد يكون شديد الحساسية لعبء العمل الذي يُختبر.
27.4. قائمة الدوال
CLUSTER: يعيد ترتيب البيانات في الجدول لتطابق الترتيب في الفهرس.