30. البيانات الشبكية (رستر)
يدعم PostGIS نوعًا آخر من أنواع البيانات المكانية يسمى raster (البيانات الشبكية). تستخدم البيانات الشبكية، كبيانات الأشكال الهندسية تمامًا، إحداثيات ديكارتية ونظامًا مرجعيًا مكانيًا. لكنها بدلًا من أن تكون بيانات متجهية، تُمثَّل بمصفوفة ذات n بُعد مكونة من بكسلات ونطاقات. تحدد النطاقات عدد المصفوفات لديك، ويخزن كل بكسل قيمة لكل نطاق. فالبيانات الشبكية ذات النطاقات الثلاثة مثل صورة RGB يكون لكل بكسل فيها 3 قيم تقابل النطاقات الأحمر والأخضر والأزرق.
مع أن الصور الجميلة مثل التي تراها على شاشة التلفاز هي بيانات شبكية، فقد لا تكون البيانات الشبكية مثيرة للنظر إلى هذا الحد. باختصار، البيانات الشبكية مصفوفة مثبّتة على نظام إحداثيات، تحمل قيمًا يمكن أن تمثل أي شيء تريده.
ولأن البيانات الشبكية تعيش في فضاء ديكارتي، فيمكنها التفاعل مع الأشكال الهندسية. يقدم PostGIS دوالًا كثيرة تأخذ مُدخلاتها من البيانات الشبكية والأشكال الهندسية معًا. وكثير من العمليات المطبقة على البيانات الشبكية ينتج عنها أشكال هندسية. ومن أشهرها ST_Polygon و ST_Envelope و ST_ConvexHull و ST_MinConvexHull كما هو موضح أدناه. وعند تحويل (cast) بيانات شبكية إلى شكل هندسي، يكون الناتج هو ST_ConvexHull للبيانات الشبكية.
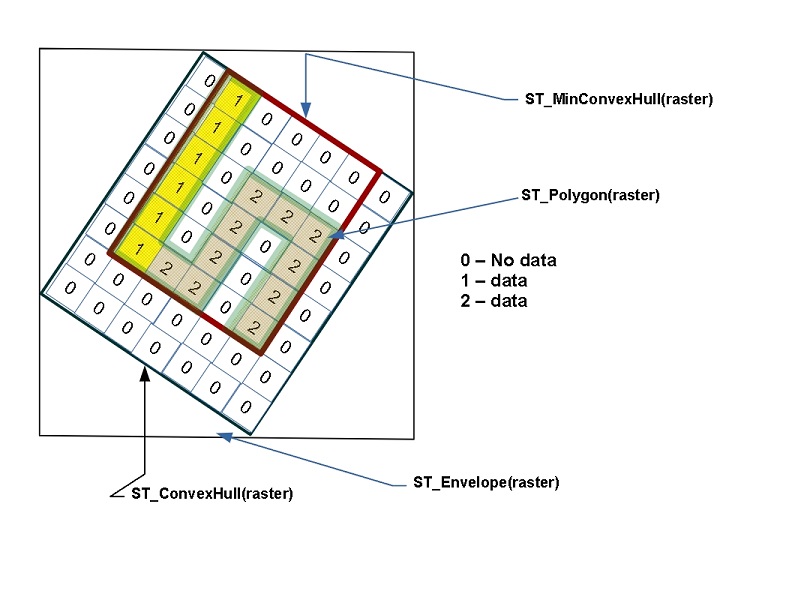
تُستخدم الصيغة الشبكية عادةً لتخزين بيانات الارتفاع، وبيانات درجات الحرارة، وبيانات الأقمار الصناعية، والبيانات الموضوعية التي تمثل أمورًا مثل التلوث البيئي والكثافة السكانية ووقوع المخاطر البيئية. يمكنك استخدام البيانات الشبكية لتخزين أي بيانات رقمية لها موقع إحداثي ذو معنى. والقيد الوحيد هو أن أنواع البيانات الرقمية يجب أن تكون متماثلة لجميع البيانات في نطاق معيّن.
مع أنه يمكن إنشاء البيانات الشبكية من الصفر في PostGIS، فإن الأسلوب الأكثر شيوعًا هو تحميلها من صيغ مختلفة باستخدام أداة سطر الأوامر raster2pgsql المرفقة مع PostGIS. وقبل كل ذلك، يجب تفعيل دعم البيانات الشبكية في قاعدة بياناتك بتنفيذ الأمر:
CREATE EXTENSION postgis_raster;
30.1. إنشاء بيانات شبكية من الأشكال الهندسية
سنبدأ أولًا بإنشاء بيانات شبكية من بيانات متجهية، ثم ننتقل إلى الأسلوب الأكثر إثارة وهو تحميل البيانات من مصدر شبكي. وستجد أن البيانات الشبكية متوفرة بوفرة، ومجانية غالبًا، في مواقع حكومية مختلفة.
سنبدأ بتحويل بعض الأشكال الهندسية إلى بيانات شبكية باستخدام الدالة ST_AsRaster كما يلي.
CREATE TABLE rasters (name varchar, rast raster);

INSERT INTO rasters(name, rast)
SELECT f.word, ST_AsRaster(geom, width=>150, height=>150)
FROM (VALUES ('Hello'), ('Raster') ) AS f(word)
  , ST_Letters(word) AS geom;

CREATE INDEX ix_rasters_rast
  ON rasters USING gist(ST_ConvexHull(rast));
ينشئ المثال أعلاه (CREATE) جدولًا (rasters) من أشكال هندسية مكوّنة من حروف باستخدام الدالة ST_Letters المتوفرة في PostGIS 3.2 فأحدث. ويمكن للبيانات الشبكية، كالأشكال الهندسية، الاستفادة من الفهارس المكانية. والفهرس المكاني المستخدم للبيانات الشبكية فهرس دالّي يفهرس الغلاف المحدب (convexhull) الهندسي للبيانات الشبكية.
يمكنك الاطلاع على بعض البيانات الوصفية المفيدة لبياناتك الشبكية بالاستعلام التالي، الذي يستخدم الدالة ST_Count من postgis raster لعدّ البكسلات التي تحتوي على بيانات، والدالة ST_MetaData لتقديم شتى المعلومات الخلفية المفيدة عن بياناتنا الشبكية.
SELECT name, ST_Count(rast) As num_pixels, md.*
   FROM rasters, ST_MetaData(rast) AS md;
name  | num_pixels | upperleftx |    upperlefty     | width | height |       scalex       |       scaley        | skewx | skewy | srid | numbands
--------+------------+------------+-------------------+-------+--------+--------------------+---------------------+-------+-------+------+----------
Hello  |      13926 |          0 | 77.10000000000001 |   150 |    150 |  1.226888888888889 | -0.5173333333333334 |     0 |     0 |    0 |        1
Raster |      11967 |          0 |              75.4 |   150 |    150 | 1.7226319023207244 | -0.5086666666666667 |     0 |     0 |    0 |        1
(2 rows)
ملاحظة
هناك مستويان لدوال البيانات الشبكية. فهناك دوال مثل ST_MetaData تعمل على مستوى البيانات الشبكية، وهناك دوال مثل الدالة ST_Count والدالة ST_BandMetaData تعمل على مستوى النطاق. ومعظم دوال postgis raster التي تعمل على مستوى النطاق تعمل على نطاق واحد فقط في كل مرة، وتفترض أن النطاق المطلوب هو 1.
إذا كانت لديك بيانات شبكية متعددة النطاقات، واحتجت إلى عدّ البكسلات ذات القيم غير الفارغة (not no-data) في نطاق غير النطاق 1، فحدد رقم النطاق صراحةً كما يلي ST_Count(rast,2).
لاحظ أن جميع البيانات الشبكية أبعادها 150x150. وهذا ليس مثاليًا، إذ يعني أنه لفرض ذلك ضُغطت بياناتنا الشبكية بشتى الطرق. لو أننا فقط نستطيع رؤية قبح البيانات الشبكية التي أمامنا.
30.2. تحميل البيانات الشبكية باستخدام raster2pgsql
raster2pgsql أداة سطر أوامر تأتي غالبًا مع PostGIS. إذا كنت تستخدم Windows واستخدمت حزمة PostGIS Bundle عبر تطبيق stackbuilder، فستجد raster2pgsql.exe في المجلد C:\Program Files\PostgreSQL\15\bin حيث يجب استبدال 15 بإصدار PostgreSQL الذي تستخدمه.
إذا كنت تستخدم Postgres.App، فستجد raster2pgsql ضمن أدوات سطر الأوامر في Postgres.app الأخرى.
على Ubuntu وDebian، ستحتاج إلى
apt install postgis
تثبيت أدوات سطر الأوامر الخاصة بـ PostGIS. وقد يثبّت هذا إصدارًا إضافيًا من PostgreSQL أيضًا. يمكنك عرض قائمة العناقيد (clusters) في Debian/Ubuntu باستخدام الأمر pg_lsclusters وحذفها باستخدام الأمر pg_dropcluster.
في هذا التمرين والتمارين اللاحقة، سنستخدم nyc_dem.tif الموجود في الملف مجموعة بيانات ورشة PG Raster https://postgis.net/stuff/workshop-data/postgis_raster_workshop.zip. وفي بعض أمثلة الأشكال الهندسية/البيانات الشبكية، سنستخدم أيضًا بيانات NYC المحمّلة في الفصول السابقة. وبدلًا من تحميل ملف tif، يمكنك استعادة nyc_dem.backup المضمّن في الملف المضغوط إلى قاعدة بياناتك باستخدام أداة سطر الأوامر pg_restore أو قائمة Restore في pgAdmin.
ملاحظة
مصدر هذه البيانات الشبكية هو NYC DEM 1-foot Integer وهو ملف tif لنموذج ارتفاع رقمي بحجم 3GB يمثل الارتفاع بالنسبة إلى مستوى سطح البحر مع إزالة المباني والمسطحات المائية. ثم أنشأنا منه نسخة أقل دقة.
تشبه الأداة raster2pgsql الأداة shp2gpsql، إلا أنها بدلًا من تحميل ملفات ESRI Shapefile إلى جداول geometry/geography في PostGIS، تحمّل أي صيغة شبكية يدعمها GDAL إلى جداول raster. وكما في shp2pgsql يمكنك أن تمرر لها معرّف النظام المرجعي المكاني (SRID) للمصدر. وعلى خلاف shp2pgsql يمكنها استنتاج النظام المرجعي المكاني لبيانات المصدر إذا كانت تحتوي على بيانات وصفية مناسبة.
للاطلاع الكامل على جميع المفاتيح المتاحة، راجع خيارات raster2pgsql.
من الخيارات البارزة الأخرى التي تقدمها raster2pgsql ولن نتناولها:
القدرة على تحديد SRID المصدر. وبدلًا من ذلك سنعتمد على مهارات raster2pgsql في التخمين.
القدرة على تعيين قيمة nodata، وعند عدم تحديدها تحاول raster2pgsql استنتاجها من الملف.
القدرة على تحميل بيانات شبكية خارج قاعدة البيانات (out-of-database).
لتحميل جميع ملفات tif في مجلدنا وإنشاء صور عامة مصغّرة (overviews) أيضًا، ننفّذ ما يلي.
raster2pgsql -d -e -l 2,3 -I -C -M -F -Y -t 256x256 *.tif nyc_dem | psql -d nyc
-d لحذف الجداول إذا كانت موجودة مسبقًا
يستخدم الأمر أعلاه -e للتحميل فورًا بدلًا من الإيداع (commit) ضمن معاملة
-C لتعيين قيود البيانات الشبكية، وهذا مفيد لكي يعرض raster_columns المعلومات. وقد ترغب في دمجه مع -x لاستبعاد قيد الامتداد، وهو قيد بطيء التحقق ويعيق أيضًا عمليات التحميل المستقبلية إلى الجدول.
-M لتنفيذ vacuum وanalyze بعد التحميل، لتحسين إحصاءات مخطِّط الاستعلامات
-Y لاستخدام copy على دفعات من 50. إذا كنت تستخدم PostGIS 3.3 أو أحدث، فيمكنك استخدام -Y 1000 لتكون الدفعات من 1000، أو حتى رقم أكبر. سيكون التنفيذ أسرع، لكنه سيستهلك ذاكرة أكثر.
-l 2,3 لإنشاء جداول الصور العامة المصغّرة: o_2_ncy_dem و o_3_nyc_dem. وهذا مفيد لعرض البيانات.
-I لإنشاء فهرس مكاني
-F لإضافة اسم الملف، وإذا كان لديك ملف tif واحد فقط فلا فائدة تُذكر من ذلك. أما إذا كانت لديك ملفات متعددة، فسيكون مفيدًا لمعرفة الملف الذي جاء منه كل صف.
-t لتعيين حجم الكتلة. لاحظ أنك إذا لم تكن متأكدًا من أفضل حجم، فاستخدم -t auto بدلًا من ذلك وستستخدم raster2pgql التقسيم إلى بلاطات نفسه الموجود في ملف tif. وسيخبرك الناتج بحجم الكتلة الذي اختارته. ألغِ العملية إذا بدا ضخمًا أو غريبًا. كان حجم الملف الأصلي 300x7 وهذا ليس مثاليًا.
استخدم psql لتنفيذ SQL المولَّد على قاعدة البيانات. وإذا أردت التفريغ إلى ملف بدلًا من ذلك، فاستخدم > nyc_dem.sql
في هذا المثال لدينا ملف tif واحد فقط، لذا يمكننا بدلًا من ذلك تحديد اسم الملف الكامل عوضًا عن *.tif. وإذا لم تكن الملفات في مجلدك الحالي، فيمكنك أيضًا تحديد مسار مجلد مع *.tif.
ملاحظة
إذا كنت تستخدم Windows واحتجت إلى الإشارة إلى المجلد، فاحرص على تضمين حرف محرك الأقراص مثل C:/workshop/*.tif
كثيرًا ما ستسمع في مصطلحات PostGIS استخدام المصطلحين raster tile (بلاطة شبكية) و raster (بيانات شبكية) بالتبادل إلى حد ما. فالبلاطة الشبكية تقابل في الواقع بيانات شبكية معينة في عمود raster، وهي جزء من بيانات شبكية أكبر، مثل بيانات نموذج الارتفاع الرقمي لنيويورك التي حمّلناها للتو. ذلك أنه عند تحميل البيانات الشبكية إلى PostGIS من ملفات شبكية كبيرة، تُقطَّع إلى صفوف كثيرة لتسهيل إدارتها. فتكون البيانات الشبكية في كل صف جزءًا من بيانات شبكية أكبر. وتغطي كل بلاطة مساحة بالحجم نفسه يحددها حجم الكتلة الذي اخترته. وللأسف، البيانات الشبكية مقيّدة بحد TOAST في PostgreSQL البالغ 1GB، وكذلك ببطء عملية فك TOAST، لذا نحتاج إلى تقطيعها لتحقيق أداء مقبول، أو حتى لنتمكن من تخزينها أصلًا.
30.3. عرض البيانات الشبكية في المتصفح
مع أن pgAdmin وpsql لا يملكان بعد آلية لعرض بيانات postgis الشبكية، فلدينا خياران. للبيانات الشبكية الصغيرة نسبيًا، الأسهل هو الإخراج إلى صيغة شبكية مناسبة للويب مثل PNG باستخدام دوال postgis raster المدمجة مثل ST_AsPNG أو ST_AsGDALRaster المدرجة في دوال الإخراج في PostGIS Raster. وكلما كبرت بياناتك الشبكية، ستحتاج إلى الانتقال إلى أداة مثل QGIS لعرضها بكامل بهائها، أو إلى عائلة أدوات سطر الأوامر في GDAL مثل gdal_translate لتصديرها إلى صيغ شبكية أخرى. لكن تذكّر أن بيانات postgis الشبكية مصمَّمة للتحليل، لا لتوليد صور جميلة للنظر إليها.
تنبيه واحد: جميع مخرجات أنواع البيانات الشبكية المختلفة معطّلة افتراضيًا. ولاستخدامها، ستحتاج إلى تفعيل المشغّلات، كلها أو بعضها، كما هو مفصّل في تفعيل مشغّلات GDAL الشبكية
SET postgis.gdal_enabled_drivers = 'ENABLE_ALL';
إذا كنت لا تريد تكرار ذلك لكل اتصال، فيمكنك تعيينه على مستوى قاعدة البيانات باستخدام:
ALTER DATABASE nyc SET postgis.gdal_enabled_drivers = 'ENABLE_ALL';
سيستخدم كل اتصال جديد بقاعدة البيانات هذا الإعداد.
نفّذ الاستعلام أدناه وانسخ الناتج والصقه في شريط العنوان في متصفح الويب.
SELECT 'data:image/png;base64,' ||
   encode(ST_AsPNG(rast),'base64')
   FROM rasters
   WHERE name = 'Hello';
في البيانات الشبكية التي أنشأناها حتى الآن، لم نحدد عدد النطاقات ولم نعرّف حتى علاقتها بالأرض. لذلك فإن لبياناتنا الشبكية نظامًا مرجعيًا مكانيًا غير معروف (0).
يمكنك أن تتصور الهيكل الخارجي للبيانات الشبكية على أنه شكل هندسي: مصفوفة مغلّفة بغلاف هندسي. ولإجراء تحليل مفيد، نحتاج إلى الإسناد الجغرافي لبياناتنا الشبكية، أي أن نجعل كل بكسل (مستطيل) يمثل قطعة ذات معنى من الفضاء.
للدالة ST_AsRaster صيغ تحميل زائد (overloads) كثيرة. استخدم المثال السابق أبسطها وقبِل الوسائط الافتراضية وهي 8BUI ونطاق واحد، مع كون القيمة الفارغة (no data) هي 0. إذا احتجت إلى استخدام الصيغ الأخرى، فاستخدم صيغة الاستدعاء بالوسائط المسمّاة حتى لا تقع عن غير قصد في الصيغة الخطأ من الدالة أو تحصل على أخطاء function is not unique.
إذا بدأت بشكل هندسي له نظام مرجعي مكاني، فستنتهي ببيانات شبكية بالنظام المرجعي المكاني نفسه. في المثال التالي، سنضع كلماتنا في نيويورك بألوان زاهية مبهجة. وسنستخدم أيضًا مقياس البكسل بدلًا من العرض والارتفاع، لكي تمثل أحجام بكسلات بياناتنا الشبكية مساحة 1 متر × 1 متر.
INSERT INTO rasters(name, rast)
SELECT f.word || ' in New York' ,
  ST_AsRaster(geom,
    scalex => 1.0, scaley => -1.0,
    pixeltype => ARRAY['8BUI', '8BUI', '8BUI'],
    value => CASE WHEN word = 'Hello' THEN
      ARRAY[10,10,100] ELSE ARRAY[10,100,10] END,
    nodataval => ARRAY[0,0,0], gridx => NULL, gridy => NULL
    ) AS rast
FROM (
    VALUES ('Hello'), ('Raster') ) AS f(word)
  , ST_SetSRID(
      ST_Translate(ST_Letters(word),586467,4504725), 26918
    ) AS geom;
إذا نظرنا إلى هذا بعد ذلك، فسنرى شكلًا هندسيًا ملوّنًا غير مضغوط.
SELECT 'data:image/png;base64,' ||
   encode(ST_AsPNG(rast),'base64')
   FROM rasters
   WHERE name = 'Hello in New York';
كرّر ذلك للبيانات الشبكية:
SELECT 'data:image/png;base64,' ||
   encode(ST_AsPNG(rast),'base64')
   FROM rasters
   WHERE name = 'Raster in New York';
والأكثر دلالة، إذا أعدنا تنفيذ
SELECT name, ST_Count(rast) As num_pixels, md.*
  FROM rasters, ST_MetaData(rast) AS md;
لاحظ البيانات الوصفية لإدخالات نيويورك. فهي بالنظام المرجعي المكاني New York state plane بوحدة المتر، ولها أيضًا مقياس الرسم نفسه. وبما أن كل وحدة هي 1x1 متر، فإن عرض كلمة Raster صار الآن أكبر من عرض Hello.
      name         | num_pixels | upperleftx |    upperlefty     | width | height |       scalex       |       scaley        | skewx | skewy | srid  | numbands
-------------------+------------+------------+-------------------+-------+--------+--------------------+---------------------+-------+-------+-------+----------
Hello              |      13926 |          0 | 77.10000000000001 |   150 |    150 |  1.226888888888889 | -0.5173333333333334 |     0 |     0 |     0 |        1
Raster             |      11967 |          0 |              75.4 |   150 |    150 | 1.7226319023207244 | -0.5086666666666667 |     0 |     0 |     0 |        1
Hello in New York  |       8786 |     586467 |         4504802.1 |   184 |     78 |                  1 |                  -1 |     0 |     0 | 26918 |        3
Raster in New York |      10544 |     586467 |         4504800.4 |   258 |     76 |                  1 |                  -1 |     0 |     0 | 26918 |        3
(4 rows)
30.4. جداول الفهرس المكاني للبيانات الشبكية
على غرار النوعين geometry وgeography، للنوع raster مجموعة من جداول الفهرسة (catalogs) تعرض لك جميع أعمدة raster في قاعدة بياناتك. وهي raster_columns وraster_overviews.
30.4.1. raster_columns
العرض (view) raster_columns هو نظير geometry_columns و geography_columns، ويقدم البيانات نفسها تقريبًا وأكثر، لكن لأعمدة raster.
SELECT *
    FROM raster_columns;
استكشف الجدول، وستجد هذا:
r_table_catalog | r_table_schema | r_table_name | r_raster_column | srid | scale_x | scale_y | blocksize_x | blocksize_y | same_alignment | regular_blocking | num_bands | pixel_types | nodata_values | out_db | extent | spatial_index
----------------+----------------+--------------+-----------------+------+---------+---------+-------------+-------------+----------------+------------------+-----------+-------------+---------------+--------+--------+---------------
nyc             | public         | rasters      | rast            |    0 |         |         |             |             | f              | f                |           |             |               |        |        | t
nyc             | public         | nyc_dem      | rast            | 2263 |      10 |     -10 |         256 |         256 | t              | f                |         1 | {16BUI}     | {NULL}        | {f}    |        | t
nyc             | public         | o_2_nyc_dem  | rast            | 2263 |      20 |     -20 |         256 |         256 | t              | f                |         1 | {16BUI}     | {NULL}        | {f}    |        | t
nyc             | public         | o_3_nyc_dem  | rast            | 2263 |      30 |     -30 |         256 |         256 | t              | f                |         1 | {16BUI}     | {NULL}        | {f}    |        | t
(4 rows)
صفًا مخيّبًا للآمال معظم معلوماته فارغة للجدول rasters.
على خلاف geometry وgeography، لا يدعم raster معدِّلات النوع (type modifiers)، لأن مساحة معدِّلات النوع محدودة جدًا، وهناك خصائص أهم مما يمكن أن يتسع له معدِّل النوع.
بدلًا من ذلك يعتمد raster على القيود (constraints)، ويقرأ هذه القيود ويعرضها جزءًا من العرض (view).
انظر إلى الصفوف الأخرى للجداول التي حمّلناها باستخدام raster2pgsql. فلأننا استخدمنا المفتاح -C أضافت raster2pgsql قيودًا لقيمة srid وغيرها من المعلومات التي تمكنت من قراءتها من ملف tif أو التي مررناها إليها. وتظهر أيضًا جداول الصور العامة المصغّرة المولَّدة بالمفتاح -l وهي o_2_nyc_dem و o_3_nyc_dem.
لنحاول إضافة بعض القيود إلى جدولنا.
SELECT AddRasterConstraints('public'::name, 'rasters'::name, 'rast'::name);
وستنهال عليك مجموعة كبيرة من التنبيهات (notices) تخبرك بأن بياناتك الشبكية في فوضى ولا يمكن تقييد أي شيء. وإذا نظرت إلى raster_columns مرة أخرى، فستجد القصة المخيّبة نفسها من الصفوف الكثيرة الفارغة للجدول rasters.
لكي تُطبَّق القيود، يجب أن تكون جميع البيانات الشبكية في جدولك قابلة للتقييد بقاعدة واحدة على الأقل.
ربما نستطيع فعل ذلك، لنكذب ببساطة ونقول إن جميع بياناتنا بنظام New York State plane.
UPDATE rasters SET rast = ST_SetSRID(rast,26918)
  WHERE ST_SRID(rast) <> 26918;

SELECT AddRasterConstraints('public'::name, 'rasters'::name, 'rast'::name);
SELECT r_table_name AS t, r_raster_column AS c, srid,
  blocksize_x AS bx, blocksize_y AS by, scale_x AS sx, scale_y AS sy,
  ST_AsText(extent) AS e
  FROM raster_columns
WHERE r_table_name = 'rasters';
آه، تقدّم:
t         |  c   | srid  | bx  | by  | sx | sy |  e
----------+------+-------+-----+-----+----+----+------------------------------------------
rasters   | rast | 26918 | 150 | 150 |    |    | POLYGON((0 -0.90000000000..
(1 row)
كلما استطعت تقييد جميع بياناتك الشبكية أكثر، رأيت أعمدة مملوءة أكثر، وتمكنت أيضًا من إجراء عمليات أكثر عبر جميع البلاطات في بياناتك الشبكية. وتذكّر أنك في بعض الحالات قد لا ترغب في تطبيق جميع القيود.
على سبيل المثال، إذا كنت تخطط لتحميل مزيد من البيانات إلى جدول البيانات الشبكية، فستحتاج إلى تخطي قيد الامتداد، لأنه سيتطلب أن تكون جميع البيانات الشبكية ضمن الامتداد المحدد في القيد.
30.4.2. raster_overviews
تظهر أعمدة الصور العامة المصغّرة للبيانات الشبكية في جدول الفهرسة الوصفي raster_columns وفي جدول فهرسة وصفي آخر يسمى raster_overviews. تُستخدم الصور العامة المصغّرة غالبًا لتسريع العرض عند مستويات التكبير الأبعد. ويمكن استخدامها أيضًا لتحليلات تقريبية سريعة، إذ تقدم إحصاءات أقل دقة لكن بسرعة أكبر بكثير من تطبيقها على جدول البيانات الشبكية الخام.
لفحص الصور العامة المصغّرة، نفّذ:
SELECT *
    FROM raster_overviews;
وسترى الناتج:
o_table_catalog | o_table_schema | o_table_name | o_raster_column | r_table_catalog | r_table_schema | r_table_name | r_raster_column | overview_factor
----------------+----------------+--------------+-----------------+-----------------+----------------+--------------+-----------------+-----------------
nyc             | public         | o_2_nyc_dem  | rast            | nyc             | public         | nyc_dem      | rast            |               2
nyc             | public         | o_3_nyc_dem  | rast            | nyc             | public         | nyc_dem      | rast            |               3
(2 rows)
لا يقدم لك الجدول raster_overviews إلا overview_factor واسم الجدول الأصل. وكل هذه المعلومات كان بإمكانك استنتاجها بنفسك من اصطلاح التسمية الذي تتبعه raster2pgsql للصور العامة المصغّرة.
يخبرك overview_factor بدقة الصف بالنسبة إلى أصله. فقيمة overview_factor تساوي 2 تعني أن 2x2 = 4 بلاطات يمكن أن تتسع في بلاطة overview_2 واحدة. وبالمثل فإن قيمة overview_factor تساوي 3 تعني أن 2x2x2 = 8 بلاطات من الأصل يمكن حشرها في بلاطة overview_3.
30.5. دوال البيانات الشبكية الشائعة
يضم الامتداد postgis_raster أكثر من 100 دالة للاختيار منها. وقد صُمّمت وظائف PostGIS raster على نمط دعم الأشكال الهندسية في PostGIS. لذا ستجد تداخلًا في الدوال بين raster وgeometry حيثما كان ذلك منطقيًا. ومن الدوال الشائعة التي ستستخدمها ولها نظير في عالم الأشكال الهندسية ST_Intersects و ST_SetSRID و ST_SRID و ST_Union و ST_Intersection و ST_Transform.
وإضافةً إلى تلك الدوال المتداخلة، يدعم المعامل && للتداخل بين البيانات الشبكية، وبين البيانات الشبكية والأشكال الهندسية. كما يقدم دوال كثيرة تعمل بالاقتران مع الأشكال الهندسية أو خاصة جدًا بالبيانات الشبكية.
تحتاج إلى دالة مثل ST_Union لإعادة تكوين منطقة. ولأن الأداء يتباطأ كلما زاد عدد البكسلات التي تحتاج الدالة إلى تحليلها، تحتاج إلى دالة سريعة هي ST_Clip لقص البيانات الشبكية إلى الأجزاء التي تهمك في تحليلك فقط.
وأخيرًا تحتاج إلى ST_Intersects أو && للتركيز على البلاطات الشبكية التي تحتوي على مناطق اهتمامك. والمعامل && أسرع من ST_Intersects. ويمكن لكليهما الاستفادة من الفهارس المكانية للبيانات الشبكية. سنتناول هذه الدوال الأساسية أولًا قبل الانتقال إلى أقسام أخرى نستخدمها فيها بالتنسيق مع دوال أخرى للبيانات الشبكية والأشكال الهندسية.
30.5.1. توحيد البيانات الشبكية باستخدام ST_Union
تقوم الدالة ST_Union الخاصة بالبيانات الشبكية، تمامًا كنظيرتها للأشكال الهندسية ST_Union، بتجميع مجموعة من البيانات الشبكية في بيانات شبكية واحدة. لكن كما في الأشكال الهندسية، لا يمكن دمج جميع البيانات الشبكية معًا، وقواعد توحيد البيانات الشبكية أعقد من قواعد الأشكال الهندسية. ففي الأشكال الهندسية كل ما تحتاجه هو أن يكون النظام المرجعي المكاني واحدًا، أما في البيانات الشبكية فهذا غير كافٍ.
إذا حاولت تنفيذ ما يلي:
SELECT ST_Union(rast)
    FROM rasters;
فستُعاقَب فورًا بخطأ:
ERROR: rt_raster_from_two_rasters: The two rasters provided do not have the same alignment SQL state: XX000
ما هذا "المحاذاة نفسها" الذي يمنعك من توحيد بياناتك الشبكية الثمينة؟
لكي تُدمج البيانات الشبكية، يجب أن تكون على الشبكة نفسها إن صح التعبير. أي يجب أن يكون لها حجم البكسل نفسه، والاتجاه نفسه (الانحراف skew)، والنظام المرجعي المكاني نفسه، وألا تقطع بكسلاتها بعضها بعضًا، أي أن تشترك في شبكة البكسلات العالمية نفسها.
إذا جربت الاستعلام نفسه، لكن بالكلمات التي وضعناها بعناية في نيويورك فقط.
مرة أخرى، الخطأ نفسه. فهي بالنظام المرجعي المكاني نفسه وحجم البكسل نفسه، ومع ذلك لا يزال هذا غير كافٍ، لأن شبكاتها غير متطابقة.
يمكننا إصلاح ذلك بإزاحة إحداثي y للزاوية العلوية اليسرى إزاحة طفيفة جدًا ثم المحاولة مجددًا. فإذا بدأت شبكاتنا عند قيم صحيحة، وبما أن أحجام البكسلات لدينا أعداد صحيحة، فلن تقطع البكسلات بعضها بعضًا.
UPDATE rasters SET rast = ST_SetUpperLeft(rast,
  ST_UpperLeftX(rast)::integer,
  ST_UpperLeftY(rast)::integer)
WHERE name LIKE '%New York';

SELECT ST_Union(rast ORDER BY name)
  FROM rasters
  WHERE name LIKE '%New York%';
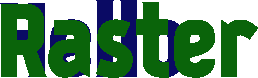
ها قد نجح الأمر، وإذا عرضناه فسنرى شيئًا كهذا:
ملاحظة
إذا لم يتضح لك يومًا سبب عدم تطابق محاذاة بياناتك الشبكية، فيمكنك استخدام الدالة ST_SameAlignment التي تقارن بيانات شبكية اثنتين أو مجموعة منها وتخبرك إن كانت لها المحاذاة نفسها. وإذا كانت التنبيهات مفعّلة لديك، فسيخبرك NOTICE بما هو غير متطابق في البيانات الشبكية المعنية. أما الدالة ST_NotSameAlignmentReason فبدلًا من مجرد تنبيه ستُخرج السبب. لكنها لا تعمل إلا على بيانات شبكية اثنتين في كل مرة.
من أبرز أوجه اختلاف دالة البيانات الشبكية ST_Union(raster) عن دالة الأشكال الهندسية ST_Union(geometry) أنها تسمح بوسيط يسمى uniontype. تكون قيمة هذا الوسيط افتراضيًا LAST إذا لم تحدده، أي خذ قيم بكسلات البيانات الشبكية الأخيرة (LAST) في الحالات التي تتداخل فيها قيم البكسلات. وكقاعدة عامة، تُتجاهل البكسلات المعلَّمة بأنها بلا بيانات (no-data) في النطاق.
كما في معظم الدوال التجميعية في PostgreSQL، يمكنك وضع عبارة ORDER BY ضمن استدعاء الدالة كما في المثال السابق. ويتيح لك تحديد الترتيب التحكم في البيانات الشبكية ذات الأولوية. ففي مثالنا السابق تغلّبت Raster على Hello لأن Raster هي الأخيرة أبجديًا.
لاحظ ما يحدث إذا عكست الترتيب:
SELECT ST_Union(rast ORDER BY name DESC)
  FROM rasters
  WHERE name LIKE '%New York%';
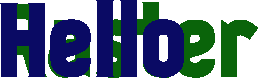
عندها تتغلب Hello على Raster لأن Hello صارت الآن الأخيرة في التراكب.
نوع التوحيد FIRST هو عكس LAST.
لكن في بعض الأحيان قد لا تكون LAST العملية الصحيحة. لنفترض أن بياناتنا الشبكية تمثل مجموعتين مختلفتين من الأرصاد من جهازين مختلفين. يقيس الجهازان الشيء نفسه، ولسنا متأكدين أيهما الصحيح عند تقاطعهما، لذا نود بدلًا من ذلك أخذ المتوسط MEAN للنتائج. سنفعل ذلك هكذا:
SELECT ST_Union(rast, 'MEAN')
  FROM rasters
  WHERE name LIKE '%New York%';
ها قد نجح الأمر، وإذا عرضناه فسنرى شيئًا كهذا:
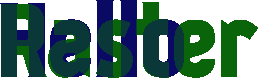
إذن بدلًا من التغلّب، لدينا مزج بين القوتين. وفي حالة نوع التوحيد MEAN لا فائدة من تحديد الترتيب، لأن النتيجة ستكون متوسط قيم البكسلات المتداخلة.
لاحظ أنه في الأشكال الهندسية، ولأنها متجهية وبالتالي ليس لها قيم سوى الوجود أو عدمه، لا يوجد في الواقع أي غموض في كيفية دمج متجهين عند تقاطعهما.
ومن ميزات ST_Union الخاصة بالبيانات الشبكية التي مررنا عليها سريعًا فكرة ما إذا كان يجب إرجاع جميع النطاقات أم بعضها فقط. فعندما لا تحدد النطاقات المراد توحيدها، تدمج ST_Union النطاقات ذات الأرقام نفسها وتستخدم استراتيجية التوحيد LAST. وإذا كانت لديك نطاقات متعددة، فقد لا يكون هذا ما تريده. فربما تريد توحيد النطاق الثاني فقط، وهو في هذه الحالة النطاق الأخضر، وتريد عدد قيم البكسلات.
SELECT ST_BandPixelType(ST_Union(rast, 2, 'COUNT'))
  FROM rasters
  WHERE name LIKE '%New York%';
st_bandpixeltype
------------------
32BUI
(1 row)
لاحظ أنه في حالة نوع التوحيد COUNT، الذي يعدّ البكسلات المملوءة ويُرجع تلك القيمة، تكون النتيجة دائمًا من النوع 32BUI، على غرار تنفيذ COUNT في SQL حيث تكون النتيجة دائمًا bigint لاستيعاب الأعداد الكبيرة.
في الحالات الأخرى لا يتغير نوع بكسل النطاق، وتُعيَّن القيمة إلى الحد الأقصى أو تُقرَّب إذا تجاوزت المقادير حدود النوع. ولماذا قد يرغب أحد في عدّ البكسلات المتقاطعة عند موقع ما؟ لنفترض أن كلًا من بياناتك الشبكية يمثل فرقة شرطة وحوادث الاعتقال في المناطق، وأن كل قيمة قد تمثل سببًا مختلفًا للاعتقال. وأنت تُجري إحصاءات عن عدد الاعتقالات في كل منطقة، لذا لا يهمك إلا عدد الاعتقالات.
أو ربما تريد معالجة جميع النطاقات، لكن باستراتيجيات مختلفة.
SELECT ST_Union(rast, ARRAY[(1, 'MAX'),
  (2, 'MEAN'),
  (3, 'RANGE')]::unionarg[])
  FROM rasters
  WHERE name LIKE '%New York%';
يتيح لك استخدام صيغة unionarg[] من الدالة ST_Union أيضًا إعادة ترتيب النطاقات.
30.5.2. قص البيانات الشبكية بمساعدة ST_Intersects
الدالة ST_Clip من أكثر الدوال استخدامًا مع بيانات PostGIS الشبكية. والسبب الرئيسي أنه كلما زاد عدد البكسلات التي تحتاج إلى فحصها أو إجراء عمليات عليها، أصبحت المعالجة أبطأ. تقص ST_Clip بياناتك الشبكية إلى منطقة الاهتمام فقط، فتتمكن من حصر عملياتك في تلك المنطقة.
تتميز هذه الدالة أيضًا بأنها تستغل قوة الأشكال الهندسية لمساعدة تحليل البيانات الشبكية. ولتقليل عدد البكسلات التي يجب على ST_Union معالجتها، تُقص كل بيانات شبكية أولًا إلى المنطقة التي تهمنا.
SELECT ST_Union( ST_Clip(r.rast, g.geom) )
  FROM rasters AS r
      INNER JOIN
        ST_Buffer(ST_Point(586598, 4504816, 26918), 100 ) AS g(geom)
          ON ST_Intersects(r.rast, g.geom)
  WHERE r.name LIKE '%New York%';
يعرض هذا المثال عدة دوال تعمل في تناغم. الدالة ST_Intersects المستخدمة هنا هي المرفقة مع postgis_raster، ويمكنها إيجاد تقاطع بيانات شبكية اثنتين أو بيانات شبكية وشكل هندسي. وعلى غرار ST_Intersects الخاصة بالأشكال الهندسية، يمكن لـ ST_Intersects الخاصة بالبيانات الشبكية الاستفادة من الفهارس المكانية على جداول البيانات الشبكية أو الأشكال الهندسية.
ملاحظة
افتراضيًا تستبعد ST_Clip البكسلات التي لا يتقاطع مركزها مع الشكل الهندسي. وقد يكون هذا مزعجًا مع البكسلات الكبيرة، وقد تفضّل بدلًا من ذلك تضمين البكسل إذا لامس أي جزء منه الشكل الهندسي. ومنذ PostGIS 3.5 أُضيف الوسيط touched. استبدل ST_Clip(r.rast, g.geom) بـ ST_Clip(r.rast, g.geom, touched => true) وها هي جميع البكسلات التي تتقاطع مع شكلك الهندسي بأي طريقة تُضمَّن.
30.6. تحويل البيانات الشبكية إلى أشكال هندسية
يمكن تحويل البيانات الشبكية إلى أشكال هندسية بالسهولة نفسها.
30.6.1. مضلع البيانات الشبكية باستخدام ST_Polygon
لنبدأ بمثالنا السابق، لكن مع تحويله إلى مضلع باستخدام الدالة ST_Polygon.
SELECT ST_Polygon(ST_Union( ST_Clip(r.rast, g.geom) ))
  FROM rasters AS r
      INNER JOIN
        ST_Buffer(ST_Point(586598, 4504816, 26918), 100 ) AS g(geom)
          ON ST_Intersects(r.rast, g.geom)
  WHERE r.name LIKE '%New York%';
إذا نقرت على عارض الأشكال الهندسية في pgAdmin، فسترى هذا بكامل بهائه دون أي حيل.
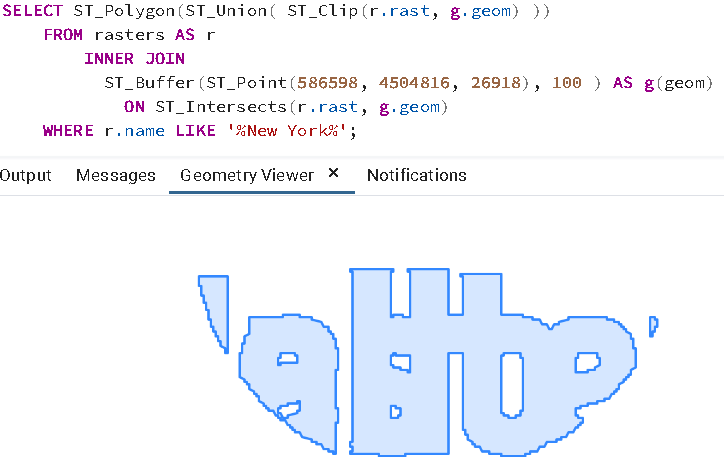
تأخذ ST_Polygon في الحسبان جميع البكسلات التي لها قيم (ليست no-data) في نطاق معين، وتحوّلها إلى شكل هندسي. وكثير من دوال البيانات الشبكية الأخرى، لا تأخذ ST_Polygon في الحسبان إلا نطاقًا واحدًا. وإذا لم يُحدَّد نطاق، فستأخذ النطاق الأول فقط.
30.6.2. مستطيلات البكسلات في البيانات الشبكية باستخدام ST_PixelAsPolygons
ومن الدوال الشائعة الاستخدام أيضًا الدالة ST_PixelAsPolygons. ونادرًا ما ينبغي استخدام ST_PixelAsPolygons على بيانات شبكية كبيرة دون قصها أولًا، لأنك ستحصل على ملايين الصفوف، صف لكل بكسل.
تُرجع ST_PixelAsPolygons جدولًا مكونًا من geom وval وx وy، حيث x رقم العمود وy رقم الصف في البيانات الشبكية.
تعمل ST_PixelAsPolygons، كغيرها من دوال البيانات الشبكية، على نطاق واحد في كل مرة، وتعمل على النطاق 1 إذا لم يُحدَّد نطاق. كما أنها افتراضيًا لا تُرجع إلا البكسلات التي لها قيم.
SELECT gv.*
  FROM rasters AS r
    CROSS JOIN LATERAL ST_PixelAsPolygons(rast) AS gv
  WHERE r.name LIKE '%New York%'
  LIMIT 10;
والتي تُخرج:
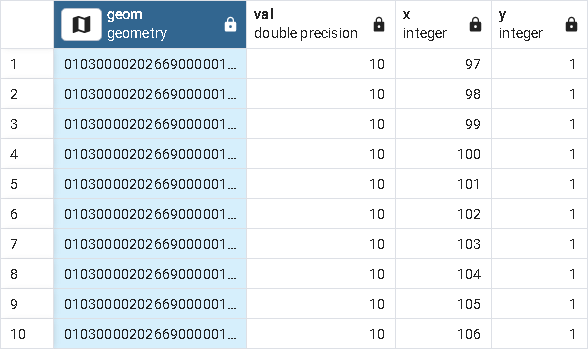
وإذا فحصناها باستخدام عارض الأشكال الهندسية، فسنرى:
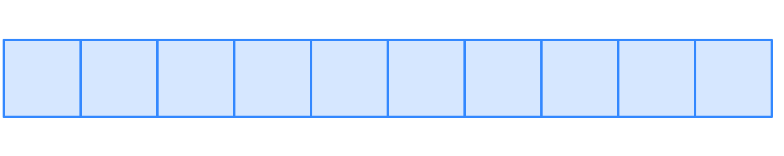
إذا أردنا جميع بكسلات جميع نطاقاتنا، فسنحتاج إلى فعل شيء كالتالي. لاحظ أوجه الاختلاف في هذا المثال عن السابق.
1. Setting exclude_nodata_value to make sure all pixels are returned so that our sets of calls return the same number of rows. The rows out of the function will be naturally in the same order.
2. Using the PostgreSQL ROWS FROM constructor , and aliasing each set of columns from our function output with names. So for example the band 1 columns (geom, val, x, y) are renamed to g1, v1, x1, x2
SELECT pp.g1, pp.v1, pp.v2, pp.v3
  FROM rasters AS r
    CROSS JOIN LATERAL
    ROWS FROM (
      ST_PixelAsPolygons(rast, 1, exclude_nodata_value => false ),
      ST_PixelAsPolygons(rast, 2, exclude_nodata_value => false),
      ST_PixelAsPolygons(rast, 3, exclude_nodata_value => false )
      ) AS pp(g1, v1, x1, y1,
        g2, v2, x2, y2,
        g3, v3, x3, y3 )
  WHERE r.name LIKE '%New York%'
   AND ( pp.v1 = 0 OR  pp.v2 > 0 OR pp.v3 > 0) ;
ملاحظة
استخدمنا CROSS JOIN LATERAL في هذه الأمثلة لأننا أردنا أن نكون صريحين فيما نفعله. وبما أن جميعها دوال تُرجع مجموعات، فيمكنك استبدال CROSS JOIN LATERAL بفاصلة , اختصارًا. وسنستخدم الفاصلة , في مجموعة الأمثلة التالية
30.6.3. تفريغ المضلعات باستخدام ST_DumpAsPolygons
تقدّم البيانات الشبكية أيضًا نوعًا مركبًا إضافيًا يسمى geomval. اعتبر geomval نتاج الشكل الهندسي والبيانات الشبكية معًا، فهو يحتوي على شكل هندسي وعلى قيمة بكسل.
ستجد عدة دوال للبيانات الشبكية تُرجع قيم geomval.
من الدوال الشائعة الاستخدام التي تُخرج قيم geomval الدالة ST_DumpAsPolygons، التي تُرجع كل مجموعة من البكسلات المتجاورة ذات القيمة نفسها على شكل مضلع. ومرة أخرى، لن تفحص افتراضيًا إلا النطاق 1 وستستبعد القيم الفارغة (no data) ما لم تغيّر ذلك. يحدد هذا المثال المضلعات من النطاق 2 فقط. ويمكنك أيضًا تطبيق مرشحات على القيم. وفي معظم حالات الاستخدام، تُعد ST_DumpAsPolygons خيارًا أفضل من ST_PixelAsPolygons لأنها تُرجع صفوفًا أقل بكثير.
سيُخرج هذا 6 صفوف، ويُرجع مضلعات تقابل حروف كلمة "Raster".
SELECT gv.geom , gv.val
  FROM rasters AS r,
    ST_DumpAsPolygons(rast, 2) AS gv
  WHERE r.name LIKE '%New York%'
      AND gv.val = 100;
لاحظ أنها لا تُرجع شكلًا هندسيًا واحدًا، لأنها تبحث عن مجموعات متجاورة من البكسلات ذات القيمة نفسها تشكّل مضلعًا. ومع أن جميع هذه القيم متماثلة، فإنها غير متجاورة.
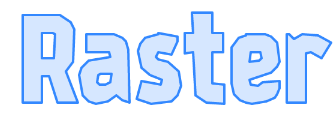
من الأساليب الشائعة لإنتاج أشكال هندسية أعقد التجميع حسب القيم ثم التوحيد.
SELECT ST_Union(gv.geom) AS geom , gv.val
  FROM rasters AS r,
    ST_DumpAsPolygons(rast, 2) AS gv
  WHERE r.name LIKE '%New York%'
  GROUP BY gv.val;
سيُرجع لك هذا صفّين يقابلان الكلمتين "Raster" و"Hello".
30.7. الإحصاءات
أهم ما يجب فهمه عن البيانات الشبكية أنها أدوات إحصائية لتخزين البيانات في مصفوفات، وقد يصادف أنك تستطيع جعلها تبدو جميلة على الشاشة.
يمكنك العثور على قائمة بهذه الدوال الإحصائية في إحصاءات نطاقات البيانات الشبكية.
30.7.1. ST_SummaryStatsAgg وST_SummaryStats
إذا أردت جميع الإحصاءات لمجموعة من البيانات الشبكية، فاستعن بالدالة ST_SummaryStatsAgg.
يستغرق هذا الاستعلام نحو 10 ثوانٍ ويعطيك ملخصًا للجدول كله:
SELECT (ST_SummaryStatsAgg(rast, 1, true, 1)).* AS sa
    FROM o_3_nyc_dem;
الناتج:
count      |    sum     |       mean       |      stddev      | min | max
-----------+------------+------------------+------------------+-----+-----
246794100  | 4555256024 | 18.4577184948911 | 39.4416860598687 |   0 | 411
(1 row)
وهو يخبرنا بأن لدينا عددًا كبيرًا من البكسلات وأن أقصى ارتفاع لدينا هو 411 قدمًا.
إذا كنت قد أنشأت صورًا عامة مصغّرة، وتحتاج فقط إلى تقدير تقريبي للقيم الدنيا والقصوى والمتوسطات، فاستخدم إحدى صورك العامة المصغّرة. يُرجع الاستعلام التالي تقريبًا القيم نفسها للدنيا والقصوى والمتوسطات كالاستعلام السابق، لكن في نحو ثانية واحدة بدلًا من 10.
SELECT (ST_SummaryStatsAgg(rast, 1, true, 1)).* AS sa
    FROM o_3_nyc_dem ;
والآن، وقد تسلّحنا بهذه المعلومات، يمكننا طرح مزيد من الأسئلة.
30.7.2. ST_Histogram
في العادة لن ترغب في إحصاءات الجدول كله، بل في إحصاءات منطقة معينة فقط، وفي هذه الحالة ستحتاج أيضًا إلى الاستعانة بصديقينا القديمين ST_Intersects و ST_Clip. وإذا احتجت أيضًا إلى دالة إحصائية للبيانات الشبكية ليس لها نسخة تجميعية، فستحتاج إلى اصطحاب ST_Union معك.
في المثال التالي سنستخدم دالة إحصائية مختلفة هي ST_Histogram التي ليس لها نظير تجميعي، وهي في هذه الصيغة تحديدًا دالة تُرجع مجموعة. نستخدم منطقة الاهتمام نفسها التي استخدمناها في بعض الأمثلة السابقة، لكننا نحتاج أيضًا إلى استخدام ST_Transform الخاصة بالأشكال الهندسية لتحويل شكلنا الهندسي بنظام NY state plane بالمتر إلى بياناتنا الشبكية بنظام NYC State Plane بالقدم. ويكون تحويل الشكل الهندسي بدلًا من البيانات الشبكية أكفأ في الأداء دائمًا تقريبًا، وبالتأكيد إذا كان شكلك الهندسي واحدًا فقط.
SELECT (ST_Quantile( ST_Union( ST_Clip(r.rast, g.geom) ), ARRAY[0.25,0.50,0.75, 1.0] )).*
    FROM nyc_dem AS r
       INNER JOIN
        ST_Transform(
          ST_Buffer(ST_Point(586598, 4504816, 26918), 100 ),
            2263) AS g(geom)
        ON  ST_Intersects(r.rast, g.geom);
يكتمل الاستعلام أعلاه في أقل من 60ms ويُخرج:
quantile  | value
----------+-------
    0.25  |    52
    0.5   |    57
    0.75  |    68
    1     |    78
(4 rows)
30.8. إنشاء بيانات شبكية (رستر) مشتقة
تأتي PostGIS raster مزوّدة بعدد من الدوال لتحرير البيانات الشبكية (رستر). تُستخدم هذه الدوال للتحرير وكذلك لإنشاء مجموعات بيانات شبكية مشتقة. ستجدها مدرجة في دوال تحرير البيانات الشبكية و دوال إدارة البيانات الشبكية.
30.8.1. تحويل البيانات الشبكية باستخدام ST_Transform
معظم بياناتنا في نظام NY State Plane بوحدة المتر (SRID: 26918)، إلا أن مجموعة بيانات نموذج الارتفاع الرقمي (DEM) الشبكية لدينا في نظام NY State Plane بوحدة القدم (SRID: 2263). وللحصول على سير عمل أقل تعقيدًا، نحتاج أن تكون مجموعات بياناتنا الأساسية في النظام المرجعي المكاني نفسه.
الدالة raster ST_Transform هي الأنسب لهذه المهمة.
لإنشاء مجموعة بيانات nyc dem جديدة في نظام NY State Plane بوحدة المتر، سننفّذ ما يلي:
CREATE TABLE nyc_dem_26918 AS
WITH ref AS (SELECT ST_Transform(rast,26918) AS rast
            FROM nyc_dem LIMIT 1)
SELECT r.rid, ST_Transform(r.rast, ref.rast) AS rast, r.filename
FROM nyc_dem AS r, ref;
استغرق ما سبق على نظامي نحو 1.5 دقيقة. ومع مجموعة بيانات أكبر سيستغرق وقتًا أطول بكثير.
استخدمت الأمثلة السابقة صيغتين من دالة البيانات الشبكية ST_Transform. الأولى للحصول على بيانات شبكية مرجعية تُستخدم لتحويل بلاطات البيانات الشبكية الأخرى لضمان أن جميع البلاطات لها المحاذاة نفسها. لاحظ أن الصيغة الثانية المستخدمة من ST_Transform لا تأخذ حتى SRID كمُدخل، لأن SRID وجميع قيم مقياس البكسل وأحجام الكتل تُقرأ من البيانات الشبكية المرجعية. ولو استخدمت الصيغة ST_Transform(rast, srid) فقد تخرج جميع بياناتك الشبكية بمحاذاة مختلفة، مما يجعل تطبيق عملية مثل ST_Union عليها مستحيلًا.
المشكلة الوحيدة في أسلوب ST_Transform السابق هي أنه عند التحويل، كثيرًا ما يقع الجزء المحوَّل في بلاطات أخرى. ولو نظرت إلى المخرجات أعلاه عن كثب بإخراج الغلاف المحدّب للبيانات الشبكية، كما في المثال التالي، لرأيت تداخلات مزعجة حول الحدود.
SELECT rast::geometry
  FROM nyc_dem_26918
  ORDER BY rid
LIMIT 100;
وعند عرضها في pgAdmin ستبدو على نحو مشابه لما يلي:
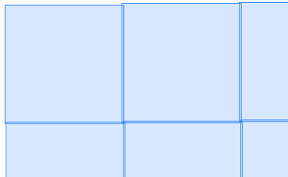
30.8.2. استخدام ST_MakeEmptyCoverage لإنشاء بيانات شبكية ذات بلاطات منتظمة
ثمة أسلوب أفضل، وإن كان أبطأ قليلًا، وهو تعريف بنية بلاطات التغطية الخاصة بك من الصفر باستخدام ST_MakeEmptyCoverage، ثم إيجاد البلاطات المتقاطعة مع كل بلاطة جديدة، ودمجها بـ ST_Union، ثم استخدام ST_Transform(ref, ST_Union...) لإنشاء كل بلاطة.
سنستخدم لذلك عددًا لا بأس به من الدوال التي تعرّفنا عليها سابقًا.
DROP TABLE IF EXISTS nyc_dem_26918;
CREATE TABLE nyc_dem_26918 AS
SELECT ROW_NUMBER() OVER(ORDER BY t.rast::geometry) AS rid,
  ST_Union(ST_Clip( ST_Transform( r.rast, t.rast, 'Bilinear' ), t.rast::geometry ), 'MAX') AS rast
FROM (SELECT ST_Transform(
    ST_SetSRID(ST_Extent(rast::geometry),2263)
        , 26918) AS geom
      FROM nyc_dem
    ) AS g, ST_MakeEmptyCoverage(tilewidth => 256, tileheight => 256,
                  width => (ST_XMax(g.geom) - ST_XMin(g.geom))::integer,
                  height => (ST_YMax(g.geom) - ST_YMin(g.geom))::integer,
                  upperleftx => ST_XMin(g.geom),
                  upperlefty => ST_YMax(g.geom),
                  scalex =>  3.048,
                  scaley => -3.048,
                  skewx => 0., skewy => 0., srid => 26918) AS t(rast)
          INNER JOIN nyc_dem AS r
            ON ST_Transform(t.rast::geometry, 2263) && r.rast
GROUP BY t.rast;
بتكرار التمرين نفسه كما في السابق:
SELECT rast::geometry
  FROM nyc_dem_26918
  ORDER BY rid
LIMIT 100;
عند العرض في pgAdmin لم تعد هناك تداخلات:
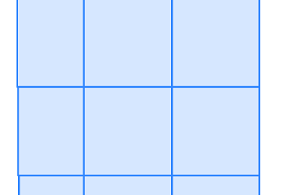
استغرق هذا على نظامي نحو 10 دقائق وأعاد 3879 صفًا. بعد إنشاء الجدول، سنرغب في القيام بالخطوات المعتادة من إضافة فهرس مكاني ومفتاح أساسي وقيود كما يلي:
ALTER TABLE nyc_dem_26918
  ADD CONSTRAINT pk_nyc_dem_26918 PRIMARY KEY(rid);

CREATE INDEX ix_nyc_dem_26918_st_convexhull_gist
    ON nyc_dem_26918 USING gist( ST_ConvexHull(rast) );

SELECT AddRasterConstraints('nyc_dem_26918'::name, 'rast'::name);
ANALYZE nyc_dem_26918;
ويُفترض أن يستغرق ذلك أقل من دقيقتين لمجموعة البيانات هذه.
30.8.3. إنشاء جداول النظرة العامة (overview) باستخدام ST_CreateOverview
كما هو الحال مع مجموعة بياناتنا الأصلية، من المفيد أن تكون لدينا جداول نظرة عامة (overview) لتسريع أداء بعض العمليات. والدالة ST_CreateOverview مناسبة لهذا الغرض. يمكنك استخدام ST_CreateOverview لإنشاء جداول النظرة العامة أيضًا إذا أغفلت إنشاءها أثناء التحميل بـ raster2pgsql أو قررت أنك تحتاج إلى مزيد منها.
سننشئ جداول النظرة العامة للمستويين 2 و 3 كما فعلنا مع بياناتنا الأصلية باستخدام هذه الشيفرة.
SELECT ST_CreateOverview('nyc_dem_26918'::regclass, 'rast', 2);
SELECT ST_CreateOverview('nyc_dem_26918'::regclass, 'rast', 3);
تستغرق هذه العملية للأسف بعض الوقت، ويطول الوقت كلما زاد عدد الصفوف، لذا تحلَّ بالصبر. استغرق الأمر لمجموعة البيانات هذه نحو 3-5 دقائق لمعامل النظرة العامة 2 ودقيقة واحدة لمعامل النظرة العامة 3.
تضيف الدالة ST_CreateOverView أيضًا القيود اللازمة كي تظهر الأعمدة بتفاصيلها الكاملة في الفهرسين raster_columns و raster_overviews. لكنها لا تضيف فهارس إليها، ولا تضيف عمود rid. وعمود rid غالبًا غير ضروري ما لم تكن بحاجة إلى مفتاح أساسي للتحرير. وغالبًا ستحتاج إلى فهرس يمكنك إنشاؤه بما يلي:
CREATE INDEX ix_o_2_nyc_dem_26918_st_convexhull_gist
    ON o_2_nyc_dem_26918 USING gist( ST_ConvexHull(rast) );

CREATE INDEX ix_o_3_nyc_dem_26918_st_convexhull_gist
    ON o_3_nyc_dem_26918 USING gist( ST_ConvexHull(rast) );
ملاحظة
للدالة ST_CreateOverview وسيط اختياري لتحديد طريقة إعادة المعاينة. وإن لم يُحدَّد فإنها تستخدم الطريقة الافتراضية NearestNeighbor، وهي عمومًا الأسرع حسابًا لكنها قد لا تكون مثالية. وطرق إعادة المعاينة خارج نطاق هذه الورشة.
30.9. تقاطع البيانات الشبكية مع الأشكال الهندسية
هناك بضع دوال شائعة الاستخدام لحساب تقاطعات البيانات الشبكية مع الأشكال الهندسية. وقد رأينا ST_Clip عمليًا، وهي تعيد تقاطع البيانات الشبكية والشكل الهندسي على هيئة بيانات شبكية، لكن هناك دوال أخرى. فبالنسبة لبيانات النقاط، الأكثر استخدامًا هي ST_Value، ثم هناك ST_Intersection التي لها عدة صيغ (overloads)، بعضها يعيد بيانات شبكية وبعضها يعيد مجموعة من geomval.
30.9.1. قيم البكسل عند نقطة هندسية
إذا احتجت إلى إعادة قيم من البيانات الشبكية بناءً على تقاطعها مع عدة نقاط هندسية مخصصة، فستستخدم ST_Value أو أقرب دالة إليها ST_NearestValue.
SELECT g.geom, ST_Value(r.rast, g.geom) AS elev
  FROM nyc_dem_26918 AS r
    INNER JOIN
    (SELECT id, geom
      FROM nyc_homicides
      WHERE weapon = 'gun') AS g
      ON r.rast && g.geom;
يستغرق هذا المثال نحو ثانية واحدة لإعادة 2444 صفًا. ولو استخدمت ST_Intersects بدلًا من && لاستغرقت العملية نحو 3 ثوانٍ. والسبب في أن ST_Intersects أبطأ هو أنها تجري تحققًا إضافيًا، وفي بعض الحالات تحققًا بكسلًا بكسلًا. فإذا كنت تتوقع أن تكون جميع نقاطك ممثلة ببيانات في مجموعة بياناتك الشبكية، وكانت بياناتك الشبكية تمثل تغطية (مجموعة متصلة من بلاطات البيانات الشبكية غير المتداخلة)، فإن && عمومًا خيار أسرع.
أما إذا كانت بياناتك الشبكية غير كثيفة، أو كانت لديك بيانات شبكية متداخلة (مثلًا تمثل أرصادًا مختلفة عبر الزمن)، أو كانت مائلة (غير محاذية للمحاور)، فهناك فائدة من ترك ST_Intersects تستبعد النتائج الإيجابية الكاذبة.
30.9.2. ST_Intersection بأسلوب البيانات الشبكية
كما يمكنك حساب تقاطع شكلين هندسيين باستخدام ST_Intersection، يمكنك حساب تقاطع بيانين شبكيين، أو بيانات شبكية مع شكل هندسي، باستخدام raster ST_Intersection.
ما تحصل عليه من هذه الدالة الضخمة نوعان مختلفان من النتائج:
عند تقاطع شكل هندسي مع بيانات شبكية تحصل على مجموعة من نواتج geomval؛ ربما واحد فقط، لكن في الغالب عدد كبير.
عند تقاطع بيانين شبكيين تحصل على raster واحد.
القاعدة الذهبية لتقاطع البيانات الشبكية وتقاطع الأشكال الهندسية على حد سواء هي أن يكون للطرفين المعنيين النظام المرجعي المكاني نفسه. وفي حالة البيانات الشبكية مع البيانات الشبكية، يجب أن تكون لهما المحاذاة نفسها أيضًا.
إليك مثالًا يجيب عن سؤال ربما راودك. إذا وزّعنا ارتفاعاتنا على 5 فئات من قيم الارتفاع، فأي نطاق ارتفاع يشهد أكبر عدد من الوفيات بالأسلحة النارية؟ نعلم من الإحصاءات التلخيصية السابقة أن 0 هي أدنى قيمة وأن 411 هي أعلى قيمة للارتفاع في مجموعة بيانات nyc dem، لذا نستخدمهما قيمتين دنيا وعليا في استدعاء width_bucket.
SELECT ST_Transform(ST_Union(gv.geom),4326) AS geom ,
  MIN(gv.val) AS min_elev, MAX(gv.val) AS max_elev,
    count(g.id) AS count_guns
  FROM nyc_dem_26918 AS r
    INNER JOIN nyc_homicides AS g
      ON ST_Intersects(r.rast, g.geom)
    CROSS JOIN
     ST_Intersection( g.geom,
      ST_Clip(r.rast,ST_Expand(g.geom, 4) )
      ) AS gv
  WHERE g.weapon = 'gun'
  GROUP BY width_bucket(gv.val, 0, 411, 5)
  ORDER BY width_bucket(gv.val, 0, 411, 5);
هل هناك ارتباط مهم بين جرائم القتل بالأسلحة النارية والارتفاع؟ على الأرجح لا.
لنلقِ نظرة على تقاطع البيانات الشبكية مع البيانات الشبكية:
SELECT ST_Intersection(r1.rast, 1, r2.rast, 1, 'BAND1')
  FROM nyc_dem_26918 AS r1
    INNER JOIN
        rasters AS r2 ON ST_Intersects(r1.rast,1, r2.rast, 1);
ما نحصل عليه صفان بقيم NULL، وإذا كان PostgreSQL لديك مضبوطًا لإظهار الإشعارات (notices) فسترى:
إشعار (NOTICE): البيانان الشبكيان المُعطيان ليس لهما المحاذاة نفسها. تُعاد القيمة NULL
لإصلاح ذلك، يمكننا محاذاة أحدهما مع الآخر من البداية باستخدام ST_Resample.
SELECT ST_Intersection(r1.rast, 1,
  ST_Resample( r2.rast, r1.rast ), 1,
    'BAND1')
  FROM nyc_dem_26918 AS r1
    INNER JOIN
        rasters AS r2 ON ST_Intersects(r1.rast,1, r2.rast, 1);
ولنجمعها أيضًا في سجل إحصائي واحد
SELECT (
  ST_SummaryStatsAgg(
    ST_Intersection(r1.rast, 1,
      ST_Resample( r2.rast, r1.rast ), 1, 'BAND1'),
        1, true)
    ).*
  FROM nyc_dem_26918 AS r1
    INNER JOIN
        rasters AS r2 ON ST_Intersects(r1.rast,1, r2.rast, 1);
والذي يُخرج:
count  |  sum  |      mean       |      stddev      | min | max
-------+-------+-----------------+------------------+-----+-----
  2075 | 99536 | 47.969156626506 | 9.57974836865737 |  33 |  62
(1 row)
30.10. دوال جبر الخرائط
جبر الخرائط هو فكرة إجراء عمليات رياضية على قيم البكسل. والدالتان ST_Union و ST_Intersection اللتان تناولناهما سابقًا حالة خاصة سريعة من جبر الخرائط. ثم هناك عائلة دوال ST_MapAlgebra التي تتيح لك تعريف عملياتك الرياضية الجامحة الخاصة، لكن على حساب الأداء.
اعتاد الناس القفز مباشرة إلى ST_MapAlgebra، ربما لأن الاسم يبدو رائعًا ومتطورًا. فمن لا يرغب في أن يقول لأصدقائه: أنا أستخدم دالة اسمها ST_MapAlgebra. نصيحتي: استكشف الدوال الأخرى قبل أن تُخرج هذا السلاح الثقيل. ستكون حياتك أبسط، وأداؤك أفضل بمئة مرة، وشيفرتك أقصر.
قبل أن نعرض ST_MapAlgebra، سنستكشف دوالًا أخرى تندرج ضمن عائلة دوال Map Algebra وتتمتع عمومًا بأداء أفضل من ST_MapAlgebra.
30.10.1. إعادة تصنيف البيانات الشبكية باستخدام ST_Reclass
من دوال جبر الخرائط التي كثيرًا ما يُغفل عنها الدالة ST_Reclass، التي تقبع في الخلفية منتظرة من يكتشف ما تقدّمه من قوة وسرعة.
ماذا تفعل ST_Reclass؟ كما يوحي اسمها، تعيد تصنيف قيم البكسل لديك بناءً على جبر نطاقات بسيط.
لنعد إلى نماذج الارتفاع الرقمي الخاصة بمدينة نيويورك. ربما لا يهمنا سوى تصنيف ارتفاعاتنا إلى 1) منخفض، 2) متوسط، 3) مرتفع، 4) مرتفع جدًا. لسنا بحاجة إلى 411 قيمة، بل إلى 4 فقط. وبناءً على ذلك، لنقم ببعض إعادة التصنيف.
يتحكم في مخطط التصنيف تعبير إعادة التصنيف.
WITH r AS ( SELECT ST_Union(newrast) As rast
  FROM nyc_dem_26918 AS r
        INNER JOIN ST_Buffer(ST_Point(586598, 4504816, 26918), 1000 ) AS g(geom)
          ON ST_Intersects( r.rast, g.geom )
        CROSS JOIN ST_Reclass( ST_Clip(r.rast,g.geom), 1,
          '[0-10):1, [10-50):2, [50-100):3,[100-:4','4BUI',0) AS newrast
        )
SELECT SUM(ST_Area(gv.geom)::numeric(10,2)) AS area, gv.val
    FROM r, ST_DumpAsPolygons(rast) AS gv
    GROUP BY gv.val
    ORDER BY gv.val;
والذي سيُخرج:
  area      | val
------------+-----
    6754.04 |   1
1753117.51  |   2
1355232.37  |   3
    1848.75 |   4
(4 rows)
لو كان هذا مخطط التصنيف الذي نفضّله، لأمكننا إنشاء جدول جديد باستخدام ST_Reclass لإعادة حساب كل بلاطة.
30.10.2. تلوين البيانات الشبكية باستخدام ST_ColorMap
الدالة ST_ColorMap دالة أخرى من دوال جبر الخرائط تعيد تصنيف قيم البكسل، إلا أنها تُنشئ نطاقات. فهي تحوّل بيانات شبكية أحادية النطاق، مثل نماذج الارتفاع الرقمي لدينا، إلى بيانات شبكية من 3 أو 4 نطاقات قابلة للعرض المرئي.
يمكنك استخدام إحدى خرائط الألوان المدمجة كما في المثال أدناه إن لم تشأ عناء إنشاء واحدة.
SELECT ST_ColorMap( ST_Union(newrast), 'bluered') As rast
   FROM nyc_dem_26918 AS r
       INNER JOIN
         ST_Buffer(
           ST_Point(586598, 4504816, 26918), 1000
           ) AS g(geom)
       ON ST_Intersects( r.rast, g.geom)
        CROSS JOIN ST_Clip(rast, g.geom) AS newrast;
والتي تبدو هكذا:
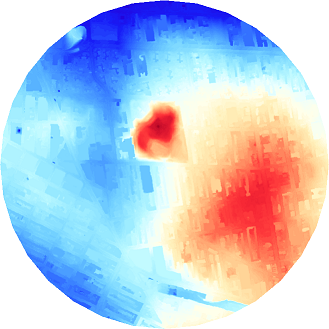
كلما كان اللون أكثر زرقة كان الارتفاع أقل، وكلما كان أكثر حمرة كان الارتفاع أعلى.